VASA-1
リアルタイムで話す顔を生成するモデル音声に合わせて表情を動かす研究モデル
主な特徴
使える場面
- オンライン教育向けのバーチャル講師
- ビデオ通話での参加者画像のリアル化
- 自然な表情を持つゲームキャラクター
使い方
- 1 現在の利用方法を確認するため、プロジェクトページを参照します。
- 2 動かしたい音声と人物の肖像を用意します。
- 3 モデルを実行して表情アニメーションを生成します。
- 4 出力を確認し、入力データを調整します。
- 5 得られた結果を自分のプロジェクトに組み込みます。
こんな方におすすめ
メリット
- 高い再現性がサイトで紹介されている
- 音声入力にリアルタイムで反応する
- 深層学習の研究機関による開発背景がある
制限事項
- 価格は未発表で、公開範囲も変わる可能性がある
- 研究プロジェクトのため、アクセスが限定されたり撤回されたりすることがある
- 同意なく実在の人物の顔を動かすと学校やプラットフォームの規定に違反する可能性があり、その結果は利用者が負う
VASA-1 とは
VASA-1は、Microsoft Researchが手がける研究モデルで、音声と同期した表情アニメーションをリアルタイムに生成することを目的としています。深層学習アルゴリズムにより、入力された話し声から口の動きや顔の表情を作り出し、仮想キャラクターが実際に話しているような自然な動きを与えます。サイトでは再現の高さとリアルタイム性が強調され、バーチャルアシスタント、オンライン教育、エンタメが主な応用分野として紹介されています。価格はまだ発表されておらず、体験用の無料トライアル版が予定されているという記載もあります。あくまで研究段階のモデルとして捉えるのがよいでしょう。
できること
- 音声クリップに合わせて口の動きをリアルタイムに生成する。
- 静止した肖像に自然な表情変化を加える。
- 講座用のバーチャル講師やプレゼンターを作る。
- ゲームや通話のキャラクターにより生々しい動きを与える。
こんな人に向いています
- 音声連動の表情アニメーションを研究する人。
- バーチャル講師を導入したいオンライン教育事業者。
- 表情豊かなキャラクターを必要とするゲーム・アプリ開発者。
注意点
研究プロジェクトであるため、利用条件や公開状況、価格は変わったり長く不明のままになったりする可能性があります。プロジェクトページで安定した提供が確認できるまで、商用製品の前提に組み込まないでください。また、顔のアニメーションには誤用のリスクがあります。同意を得ていない人物の画像を使ったり、学校やプラットフォームの規定に違反する形で公開したりした場合、その結果は利用者が負います。ブラウザーや端末によって挙動が異なることもあるため、本番利用の前に試し、エラーが出たらヘルプを確認してください。仕様や画面構成も版によって変わるため、着手前に最新の案内を読みましょう。
よくある質問
VASA-1は誰が作ったものですか?
Microsoft Researchが開発しました。
利用できますか?
プロジェクトページでは研究モデルとして紹介されています。利用可否の詳細はそちらで確認してください。
どんな用途がありますか?
バーチャルアシスタント、オンライン教育、エンタメが主な応用分野として挙げられています。
費用はかかりますか?
価格は未発表です。体験用の無料トライアル版が予定されているとページに記載されています。
無料で使える理由
公式ページの記載内容: 無料トライアル
無料の上限、トライアル期間、機能は公式サイトが決定し、いつでも変更される場合があります。
製品プレビュー
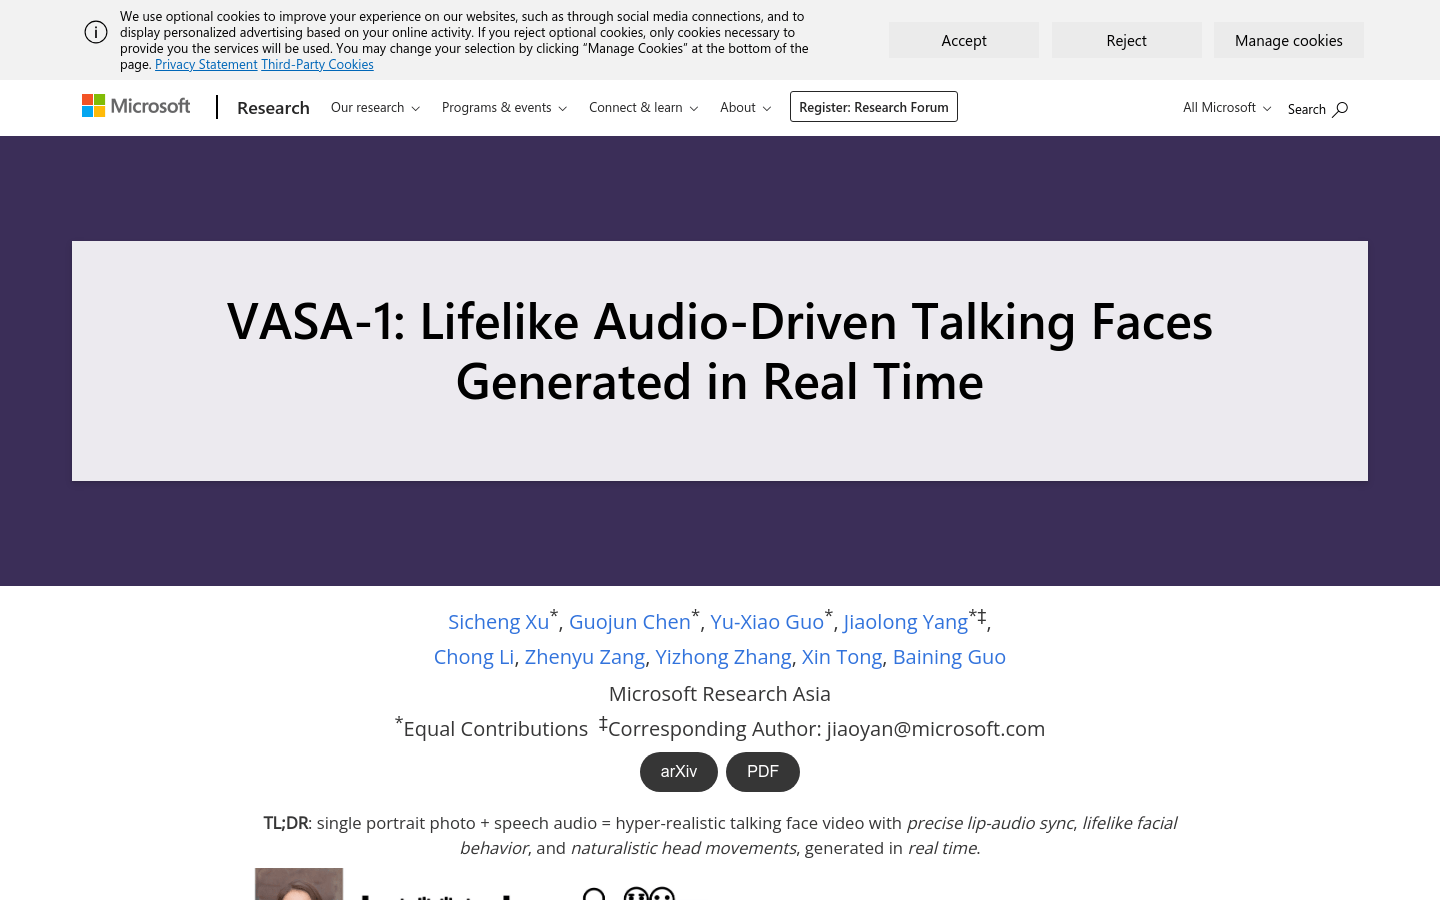
一覧ページから保存したスクリーンショットです。プレビュー専用です。