MediaTek Research Breeze-7B
オープンソースの7B二言語言語モデル中国語と英語を扱うMediaTek Research製
主な特徴
使える場面
- 二言語のリアルタイム翻訳を動かす
- 中国語と英語の顧客対応ボットを作る
- 二言語の表データを解析・生成する
使い方
- 1 オープンソースのMR Breeze-7Bをダウンロードする
- 2 70億パラメータを動かせる環境を用意する
- 3 モデルを読み込み、二言語の作業で試す
- 4 翻訳・顧客対応・分析に合わせて調整する
こんな方におすすめ
メリット
- オープンソースで無料が謳われています
- 前身より繁体字の微妙さを扱いやすい
- 応答速度に配慮した設計
制限事項
- 70億パラメータを動かすには相応の機器が必要です
- 同規模のモデルは難しい推論で大型モデルに劣ります
- 公開とサポートは上流の研究機関に依存します
MediaTek Research Breeze-7B とは
MediaTek Researchが公開したMR Breeze-7Bは、中国語と英語を得意とする70億パラメータのオープンソース大規模言語モデルです。以前のBLOOM-3Bと比べると約20倍の知識を取り込んでおり、繁体字中国語に含まれる文化や言語の細かい違いを、より正確に扱えるよう調整されています。応答の速さも重視され、公開情報では無料で使えると説明されています。想定される用途は二言語の翻訳、知的な顧客対応、データ分析で、表形式の内容を読み解いたり作り出したりする場面も含まれます。オープンソースである実務的な意味は大きく、重みを確認し、自社内で動かし、必要に応じて調整できる点です。
できること
- 中国語と英語の生成や翻訳を動かす
- 繁体字の細かい表現を踏まえて文章を扱う
- 二言語の顧客対応アシスタントを支える
- 表データの読み取りと作成を行う
- データを外部に出さず自前で運用する
こんな人に向いています
- 中国語と英語の機能を持つアプリを作る開発者
- 二言語モデルの振る舞いを研究する人
- データ管理の理由から自前運用を選ぶチーム
- 繁体字の利用者に向けたサービスを作る製品チーム
- 小回りの利く二言語モデルを探す技術者
注意点
70億パラメータ規模のモデルを手元で動かすには、それなりのGPUや十分なメモリが必要です。速さに優れていても、必要な機器が要る点は変わりません。この大きさのモデルは、難しい推論、長い文脈、事実の正確さの点で、より巨大なモデルに及ばないことがあります。重要な出力はそのまま信じず、必ず確かめてください。公開される重みやライブラリ、保守の状況はMediaTek Researchに依存し、入手環境が変わる可能性があります。商用製品に組み込む前にライセンス条項を確認し、自分のデータで性能を測ってから判断してください。
よくある質問
モデルの規模はどれくらいですか。
70億パラメータです。
どの言語を扱いますか。
中国語と英語で、繁体字中国語の文化的な微妙さにも配慮しています。
無料ですか。
はい。オープンソースモデルとして公開され、無料で使えると案内されています。
無料で使える理由
公式ページの記載内容: 無料で利用可能
無料の上限、トライアル期間、機能は公式サイトが決定し、いつでも変更される場合があります。
製品プレビュー
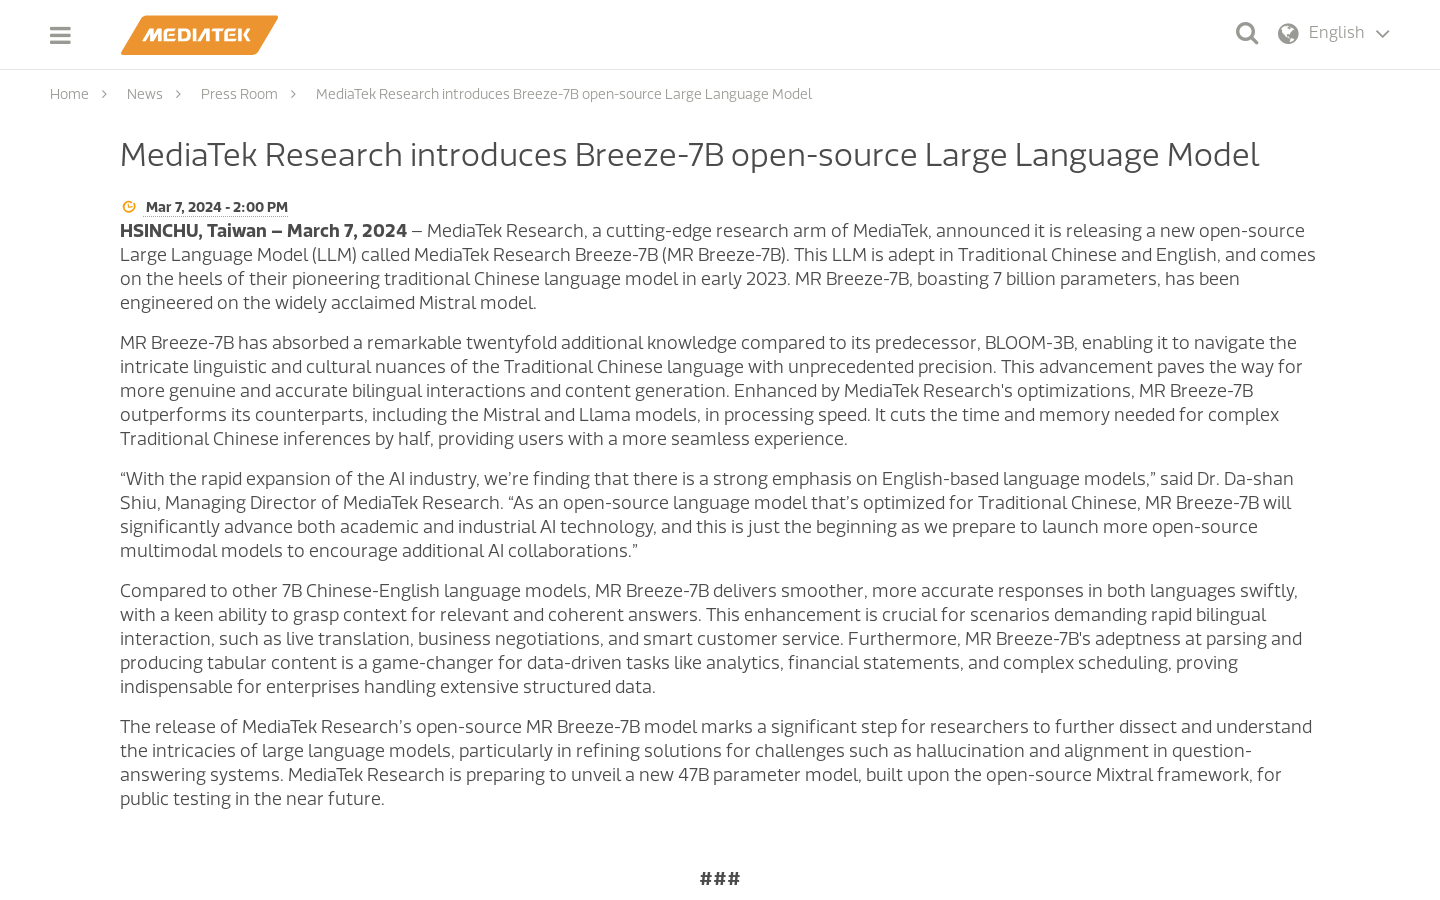
一覧ページから保存したスクリーンショットです。プレビュー専用です。