主な特徴
使える場面
- 企業サイトからB2Bの見込み客リストを作る
- 複数ページの競合価格を監視する
- 記事のタイトルと要約を分析用に集める
使い方
- 1 Firecrawl Extract のサイトで登録する
- 2 プランを選ぶ。まずは無料版から試すこともできる。
- 3 抽出したい項目を自然言語で説明する。
- 4 APIまたはWeb画面で抽出を実行する。
- 5 構造化データを自分のツールへ読み込む。
こんな方におすすめ
メリット
- 指定項目を指示で伝えるため、セレクターの保守が不要
- 一回の呼び出しでサイト全体を扱える
- 無料版で作業の流れを試せる
制限事項
- 無料枠は有料プランより制限が大きい
- 抽出の正確さはページ構成と指示の明確さに左右される
- スクレイピングは利用規約とrobots.txt のルールを守る必要がある
- 対象サイトのレイアウト変更が結果に影響する場合がある
Firecrawl Extract とは
Firecrawl Extract は、Webページの内容を構造化データへ変えるAI抽出ツールです。ページが変わるたびに壊れやすいセレクター付きのスクレイピング用スクリプトを書いて保守する代わりに、欲しい情報を普段の言葉で説明すると、構造化された形で返します。API一回の呼び出しで一つのページを対象にすることも、サイト全体をたどることもでき、結果はZapierなどのツールへ流して自動化に使えます。多言語のページや国際向けサイト、コンテキストウィンドウの上限を気にせず扱う大きな抽出にも対応すると案内されています。無料版と有料プラン、法人向けプランが並んでおり、小さな試行から大きな処理の流れまで同じ場所で始められます。
できること
- 自然言語の指示で欲しい項目を抽出する。
- API一回でサイト全体から情報を取得する。
- 多言語ページや国際向けサイトを扱う。
- Zapierなどへの連携で、後工程につなげる。
- 無料での試用から有料の本番運用へ広げる。
こんな人に向いています
- 見込み客リストや市場向けデータセットを作るデータチーム。
- クローラーを保守せずにサイト情報が欲しい開発者。
- 競合のページや価格を継続的に見たいアナリスト。
注意点
無料枠には上限があるため、継続的に大量の情報を扱うなら有料プランが必要です。抽出の正確さは対象ページの構造と、指示文がどれだけ明確かに左右されます。スクリプトが多用された複雑なページでは、結果が欠ける場合があります。Webから情報を取得する際は、対象サイトの利用規約とrobots.txt のルールを守る必要があり、その責任は利用者にあります。対象側のレイアウトが変わると、ツールが変化に適応しても出力へ影響することがあるため、重要な処理へ流す前に結果を検証してください。ブラウザや端末によって挙動が異なる場合もあるため、本番利用の前に確認し、エラーが出たらヘルプ文書を参照してください。抽出した項目の表記ゆれをそろえる作業も、実用では必要になります。
よくある質問
スクレイピング用スクリプトを書く必要はありますか?
いいえ。欲しい情報を自然言語で説明すると、抽出を処理します。
無料版はありますか?
はい。有料プランや法人向けプランと並んで無料版が案内されています。
大きな抽出にも対応できますか?
大規模な抽出やAPIによるサイト全体の取得に対応すると明記されています。
無料で使える理由
公式ページの記載内容: 無料版
無料の上限、トライアル期間、機能は公式サイトが決定し、いつでも変更される場合があります。
製品プレビュー
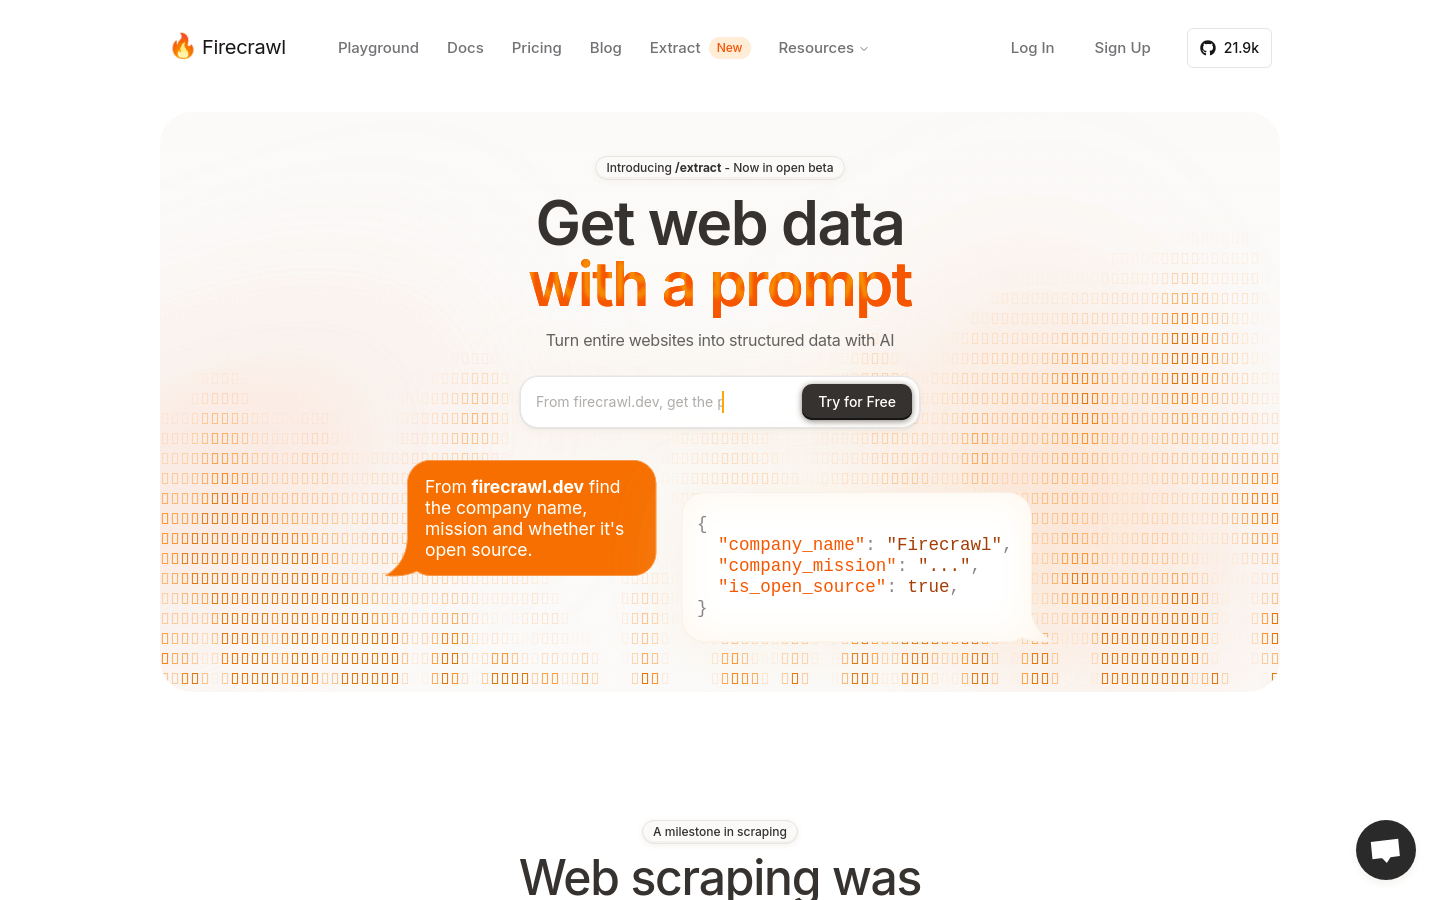
一覧ページから保存したスクリーンショットです。プレビュー専用です。