主な特徴
使える場面
- バーチャルプレゼンター動画をコンテンツ制作で使う
- 地域や言語向けの製品紹介動画を作る
- 写真と台本から授業用動画を作る
- 研究で音声映像生成を試す
使い方
- 1 鮮明な正面のポートレートと、台本または音声ファイルを用意する
- 2 256p、720p、1080pなど出力解像度を選ぶ
- 3 入力を送信し、生成が終わるまで待つ
- 4 完成した動画をダウンロードする
- 5 必要ならHugging Faceから重みを取得して自前で動かす
こんな方におすすめ
メリット
- 寛容なライセンスで重みが公開されている
- 必要な写真が1枚だけで始めやすい
- 別の音声合成ステップが不要
- 適切なハードウェアでは推論が速い
制限事項
- ホスト版デモの利用条件はモデルライセンスと異なる場合がある
- リアルなトーキングヘッドはなりすましに悪用されるおそれがある。本人の同意なく他人の顔や声を使うと、プラットフォームの規定や法律に違反する可能性があり、その結果は利用者が負う
- 記載された速度はH100クラスのGPUを前提としている
DaVinci MagiHuman とは
DaVinci MagiHumanは、1枚のポートレート写真と台本または音声を使って、発話に合わせて口が動く動画を生成するオープンソースモデルです。音声と映像を別々に用意して後から合わせるのではなく、一度の生成で両方を扱う点が特徴です。150億パラメーターのモデルで、重みとコードはApache 2.0のもとで公開されています。無料で使えるホスト版デモも用意されているため、まずはデモで動作を確認できます。
できること
- 1枚の参考ポートレートから、話す人物の動画を作る。
- 台本または音声を入力に、口の動きを合わせた映像を生成する。
- 音声と映像を同じ処理で作り、別の音声合成工程を省く。
- 256pから1080pまで、出力解像度を選んで生成する。
こんな人に向いています
- プレゼンター動画やバーチャルアナウンサー動画を作る制作者
- 音声と映像の生成を研究する研究者
- 製品紹介動画を複数言語で作りたいマーケター
- オープンソースモデルを自前環境で試したい開発者
注意点
ホスト版デモとモデル本体のライセンスは別の話なので、デモを使う前にその利用条件を確認してください。リアルな話す人物の動画は、本人の同意がないまま使うと重大な問題になります。他人の顔や声を無断で使うなりすまし目的の利用は、学校やプラットフォームの規定に違反する可能性があり、結果は利用者が負います。記載された推論速度はH100クラスのGPUが前提です。自前運用ではハードウェアの準備が必要で、まず小さな動画で手順を確認するとよいでしょう。
よくある質問
DaVinci MagiHumanは無料で使えますか?
モデルの重みとコードはApache 2.0で公開され、無料のオンラインデモもあります。ただしホスト版デモには独自の条件がある場合があり、自前運用ではライセンスを守る必要があります。
動画生成には何が必要ですか?
鮮明な正面のポートレート写真と、台本または音声ファイルが必要です。
生成速度はどのくらいですか?
提供元によれば、1枚のNVIDIA H100で設定にもよりますが、256pの2秒動画を約2秒で生成できるとされています。
誰が開発しましたか?
Sand aiと上海交通大学のGAIR Labにより公開された、150億パラメーターのモデルです。
無料で使える理由
公式ページの記載内容: 免费zh-継承済み
無料の上限、トライアル期間、機能は公式サイトが決定し、いつでも変更される場合があります。
製品プレビュー
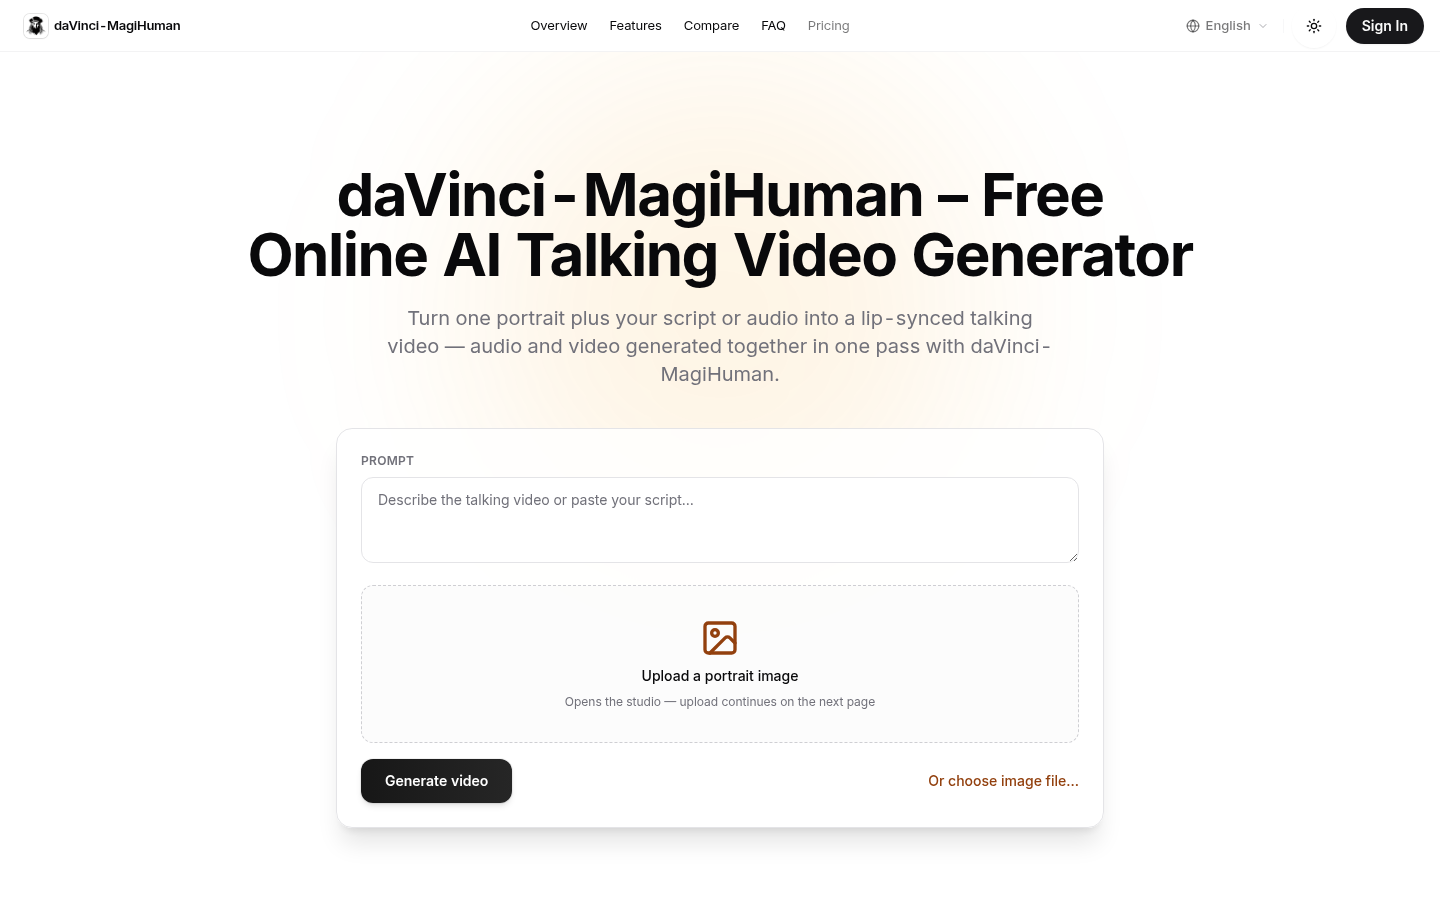
一覧ページから保存したスクリーンショットです。プレビュー専用です。