Chunkr
RAG向けのオープンソース文書取り込みAPI文書を構造化し、モデルが使える形へ
主な特徴
使える場面
- 企業がPDFの伝票を構造化データに変換して分析
- 研究者が論文を機械で読めるテキストにする
- 学校が教科書やノートをデジタル教材へ変換
使い方
- 1 Chunkrのサイトでアカウントを登録します
- 2 ログイン後に新しい取り込みタスクを作成します
- 3 PDF、DOC、PPT、XLSファイルをアップロードします
- 4 レイアウト解析、OCR、チャンク処理を実行させます
- 5 構造化データをダウンロードするかAPIで取得します
- 6 解析、学習、業務の工程へ結果を移します
こんな方におすすめ
メリット
- レイアウト、OCR、チャンクを一つのサービスで処理
- 1500ページ分の無料クレジットで試せる
- API中心なので既存の工程に組み込みやすい
- オープンソースで資料も揃っている
制限事項
- 無料クレジットを使い切ると大容量は有料になります
- スキャンや手書きは鮮明なテキストより精度が落ちます
- 複雑なレイアウトは人手での確認が必要です
- 出力を使う先の正確さは利用者が責任を持ちます
Chunkr とは
Chunkrは文書を機械が扱える形に変える、オープンソースのデータ取り込みAPIです。レイアウト解析で文字やブロックの位置を把握し、OCRでスキャンや画像から文字を読み取り、チャンク処理で本文、表、画像、手書き部分に分けます。出力はRAGやLLMアプリで使うことを想定した構造になっています。PDF、DOC、PPT、XLSに対応し、APIとドキュメント、GitHubの資料が用意されています。保守はLumina AI Inc.が行っています。登録すると1500ページ分の無料クレジットが使え、以降は有料プランに切り替わります。
できること
- 混在形式の文書に対してレイアウト解析を実行します。
- スキャンページや画像をOCRでテキスト化します。
- 内容をチャンク、表、画像への参照に分けます。
- 結果をAPI経由で自分の工程へ取り込みます。
- 構造化データをRAGや学習の入力に使います。
こんな人に向いています
- 文書群をもとにRAGやLLM機能を作る開発者。
- 紙の記録、伝票、スキャン書類をデジタル化するチーム。
- 分析用のテキスト資料を整える研究者。
注意点
構造化された出力の質は、元の文書の状態に左右されます。鮮明なデジタルPDFは処理しやすい一方、画質の悪いスキャン、手書き、変わったレイアウトは精度が落ち、目視での確認が必要です。表の検出は特に使う前に確かめてください。1500ページの無料分は開始用の枠であり、永続的な無料プランではありません。出力の上に作った仕組みも、元データの誤りを引き継ぎます。規模を広げる前にサンプルで確認してください。
よくある質問
Chunkrはオープンソースですか?
はい。Lumina AI Inc.が保守するオープンソースのデータ取り込みAPIと説明されています。
どのファイル形式に対応していますか?
PDF、DOC、PPT、XLSです。OCRによりスキャン文書も扱えます。
無料でどれくらい処理できますか?
開始用に1500ページ分のクレジットが用意され、それ以上は有料プランが必要です。
無料で使える理由
公式ページの記載内容: 無料トライアル
無料の上限、トライアル期間、機能は公式サイトが決定し、いつでも変更される場合があります。
製品プレビュー
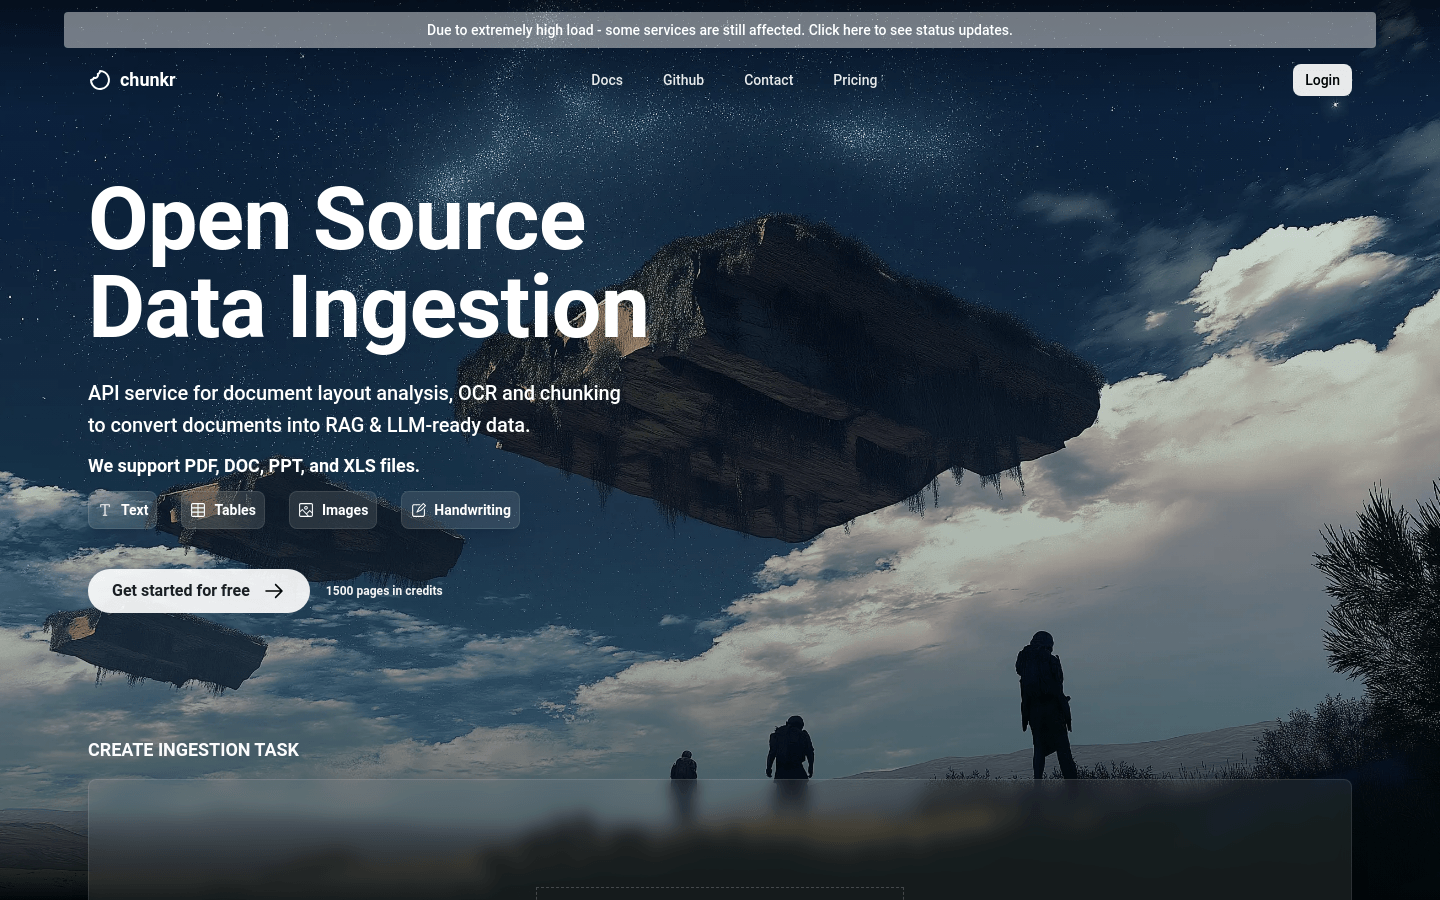
一覧ページから保存したスクリーンショットです。プレビュー専用です。