AnyParser Pro
PDF・PPT・画像向けLLM文書解析ツールAIで文書からテキストや表を取り出す
主な特徴
使える場面
- PDFレポートから分析用の数値を取り出す
- スライド資料から情報を抽出する
- 論文内の画像から文字を読み取る
使い方
- 1 アカウントを登録しAPIキーを取得する
- 2 PDF・PPT・画像ファイルをアップロードする
- 3 解析モード(本文・表・キーと値)を選ぶ
- 4 処理を待ち、抽出結果をダウンロードする
こんな方におすすめ
メリット
- 画像を含む複数形式に対応
- 用途に合わせた抽出モード
- 無料トライアルと簡単なAPIアクセス
制限事項
- API利用のため初期設定と技術的な理解が必要
- 無料トライアルでは量に上限があり、条件も変わる場合がある
- 解析精度は文書の品質に左右される
AnyParser Pro とは
AnyParser ProはCambioMLが開発した文書解析ツールです。大規模言語モデルを使い、PDFやPPT、画像ファイルの中から必要な内容を取り出します。本文全体、表だけ、キーと値の組など、抽出形式を選べるのが特徴です。画像に含まれた文字も読み取れるため、スキャンした資料にも対応できます。利用には登録とAPIキーが必要で、ファイルをAPIへ送信して処理します。無料トライアルが用意され、PDFの最初の10ページを扱えます。手作業で文章や表を写す時間を減らしたい人に向けた設計です。Y Combinatorの支援を受けたチームが開発しています。
できること
- PDFレポートから分析向けの本文や表を取り出す。
- スライド資料に書かれた情報を抽出する。
- 論文に載っている画像内の文字を読み取る。
- ファイルをAPIに送り、既存のデータ処理の流れに組み込む。
こんな人に向いています
- 報告書を扱う金融やデータのアナリスト。
- 論文や発表資料から文字を集める研究者。
- APIを使う業務に文書解析を追加したいチーム。
注意点
API経由のサービスなので、導入にはある程度の技術的な理解が要ります。無料トライアルには処理量の上限があり、提供条件は今後変わる可能性もあります。解析結果は元ファイルの状態に左右され、文字が崩れたスキャンや複雑なレイアウトでは精度が落ちることがあります。開発は初期段階のスタートアップなので、機能や提供状況が変わることもあります。自分のファイルで事前に試してから、大きな作業に使うのが安心です。ブラウザーや端末によって動作が異なる場合もあるため、実際の運用前に確認し、エラーが出たらヘルプ資料を参照してください。
よくある質問
どのファイルを解析できますか?
PDF、PPT、画像ファイルです。
どう利用しますか?
登録してAPIキーを取得し、ファイルをAPIに送信します。
無料トライアルはありますか?
はい。PDFの最初の10ページを解析できます。
無料で使える理由
公式ページの記載内容: 無料トライアル
無料の上限、トライアル期間、機能は公式サイトが決定し、いつでも変更される場合があります。
製品プレビュー
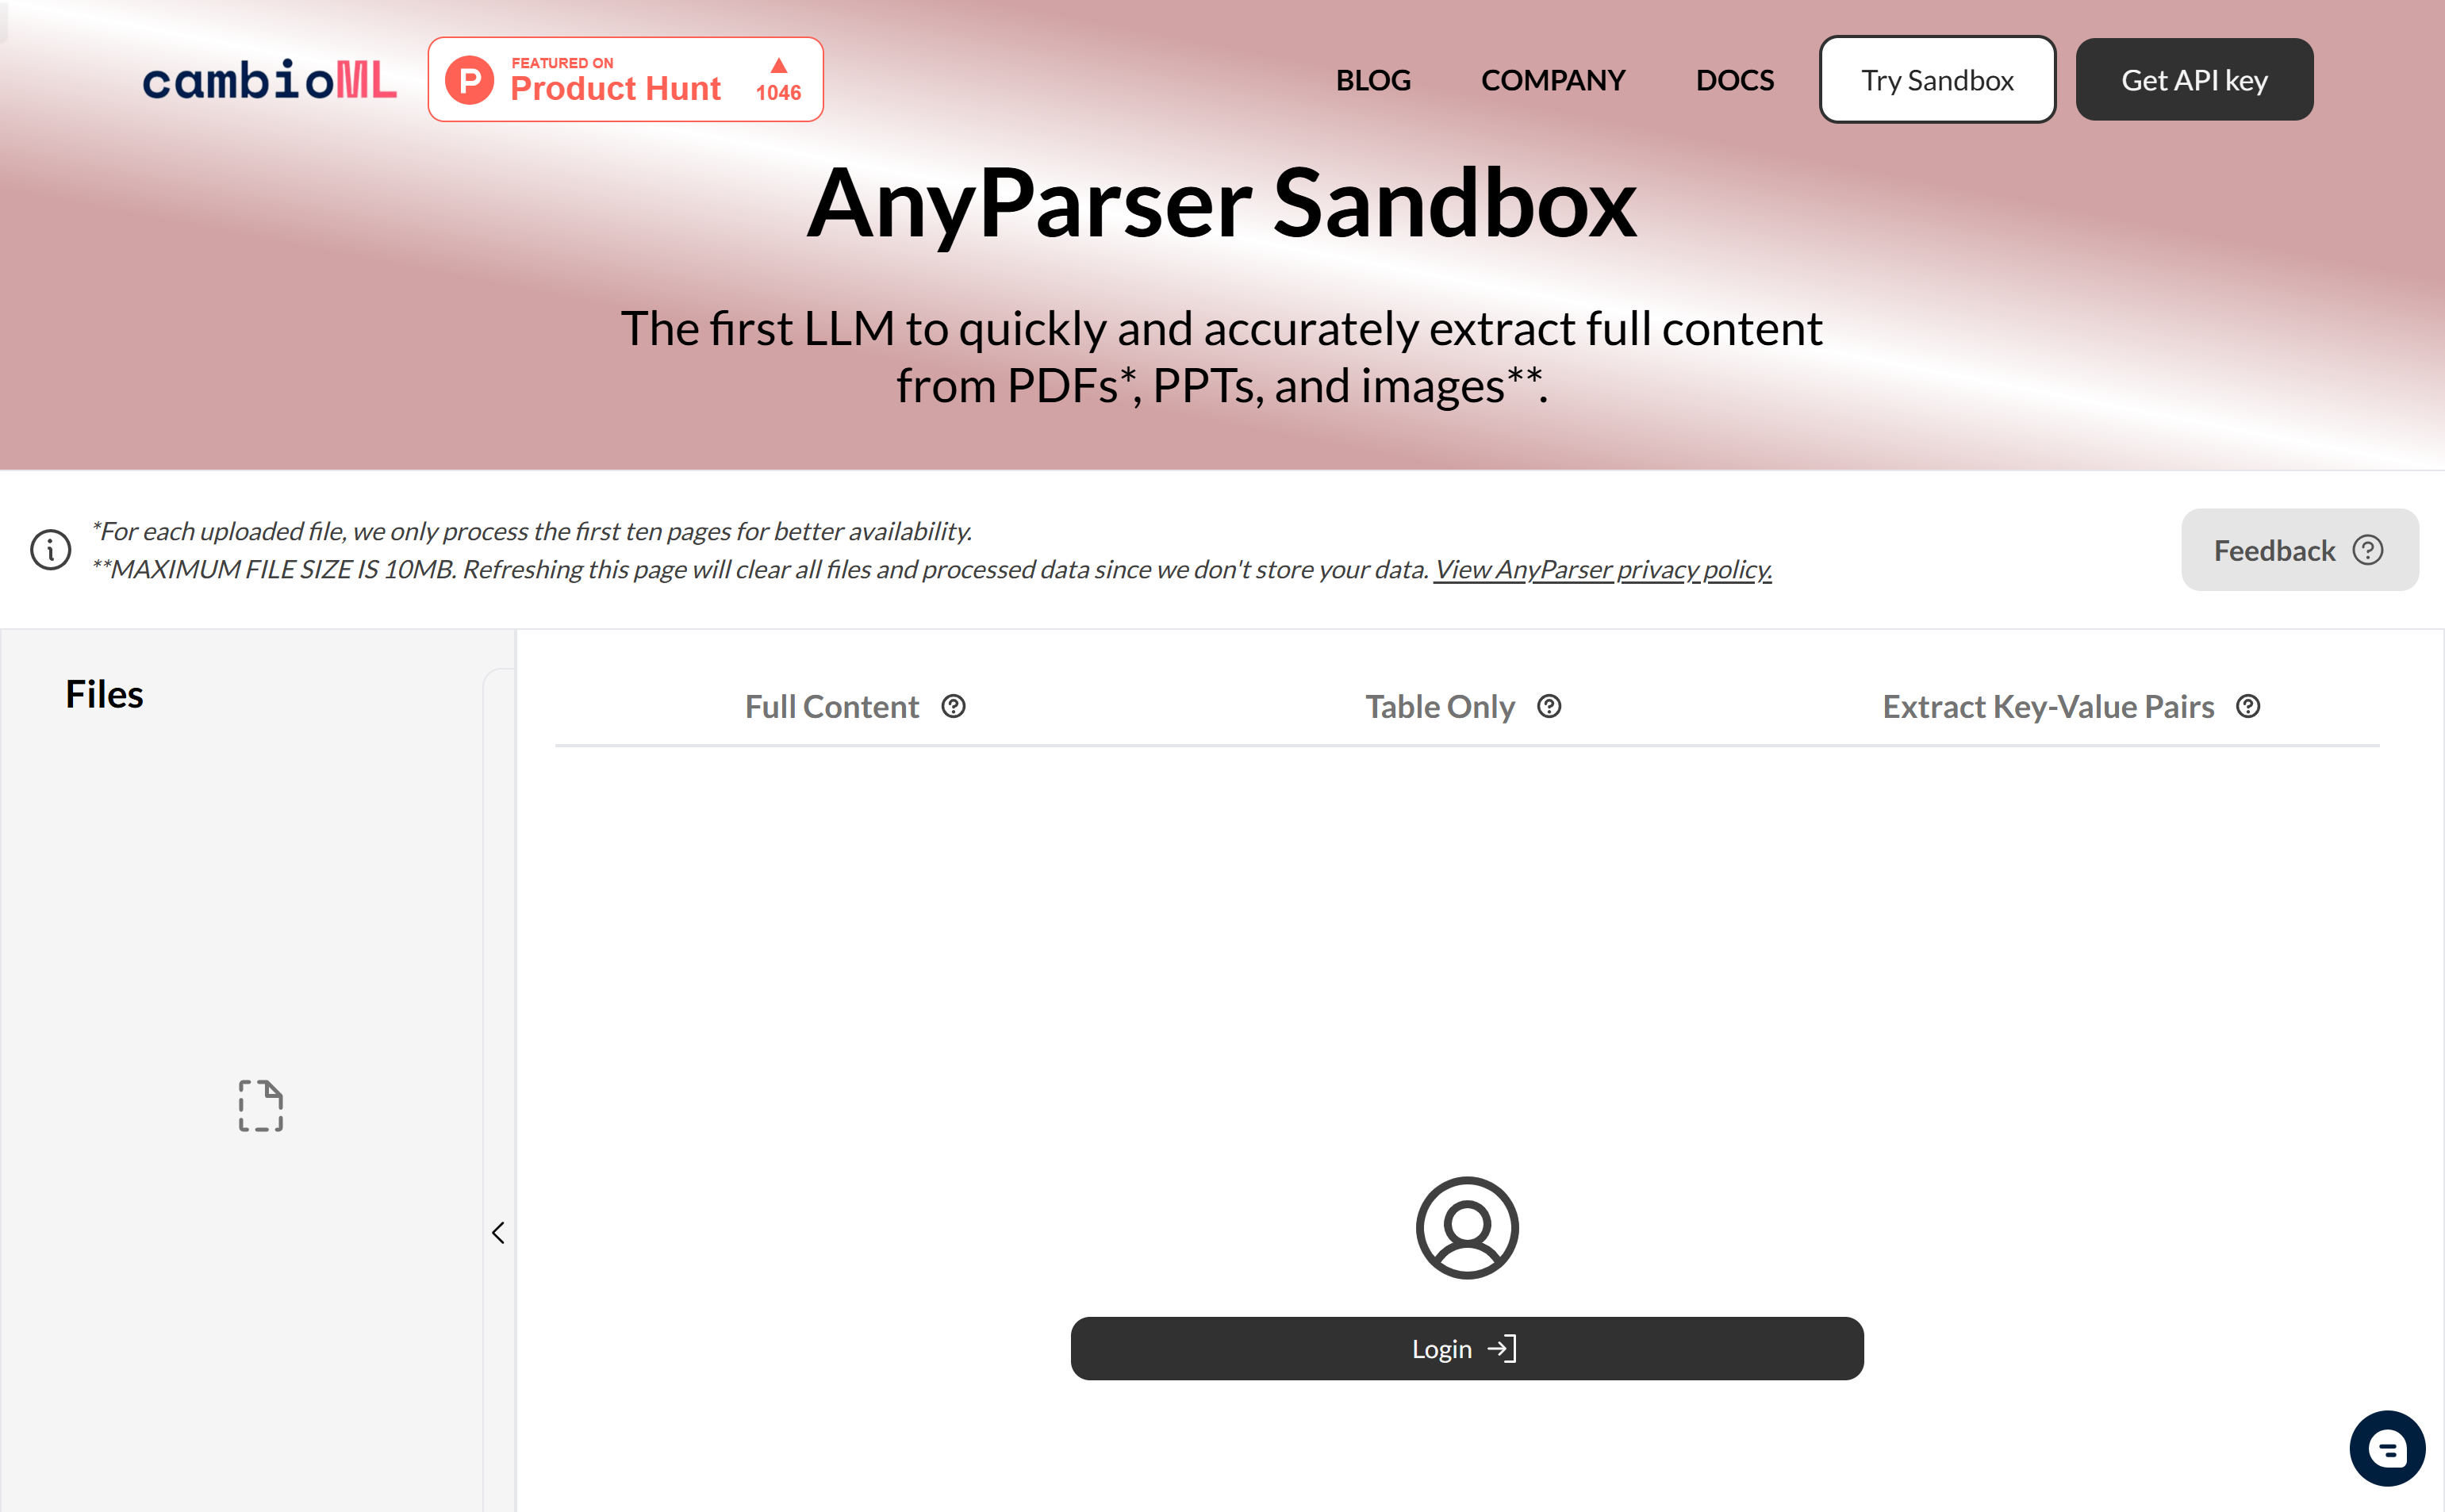
一覧ページから保存したスクリーンショットです。プレビュー専用です。